AI voorraadbeheer data: gids voor data-integratie stappen
De uitdaging van grootschalige logistiek vereist een fundament van nauwkeurige informatie om fouten te voorkomen. Het optimaliseren van AI voorraadbeheer data is de sleutel tot het beheersen van complexe uitstroomprocessen en het voorkomen van tekorten. Dit artikel verkent waarom data-integriteit cruciaal is voor AI-gestuurde systemen, hoe investeringen zich terugbetalen en welke structuren nodig zijn voor efficiëntie.
Waarom data voor AI voorraad essentieel is bij grote leveringen?
Terwijl de vrachtwagens bij de laadperrons staan te wachten, voelt de manager de spanning in zijn handen tijdens het controleren van het voorraadbeheer.
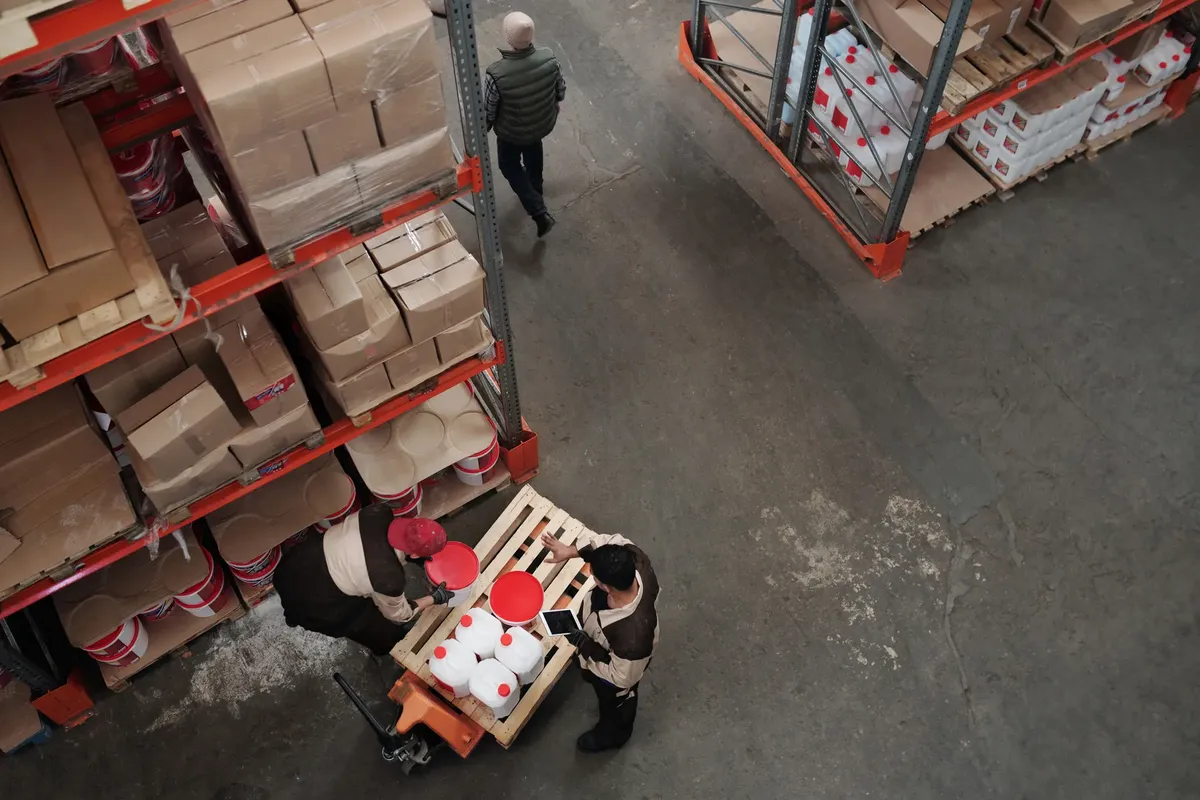
Een magazijnmanager kijkt naar een scherm vol fluctuerende cijfers terwijl vrachtwagens klaarstaan voor vertrek. In een omgeving waar volumes constant veranderen, vormt de kwaliteit van de input de basis voor elke voorspelling.
Zonder betrouwbare gegevens kan een algoritme geen zinvolle beslissingen nemen over bestelmomenten of verzendprioriteiten.
Het verzamelen van AI voorraadbeheer data stelt bedrijven in staat om patronen te herkennen die voor het menselijk oog onzichtbaar blijven. Wanneer een systeem moet reageren op plotselinge pieken in de vraag, zijn historische gegevens en realtime updates nodig om de balans te bewaren.
Een gebrek aan accurate data leidt direct tot verkeerde voorraadniveaus.
Het belang van een solide datastructuur wordt benadrukt door de kloof tussen kleine bedrijven en geavanceerde logistieke spelers. Volgens informatie over de markt opereert momenteel 43% van de kleine bedrijven zonder enige vorm van voorraadtracking.
Dit contrast laat zien hoe kwetsbaar bedrijven zijn die niet vertrouwen op digitale systemen.
Het gebruik van AI uitstroom data nodig hebben bedrijven om de doorloopnelheid te maximaliseren. In plaats van reactief te handelen, kunnen systemen proactief capaciteit reserveren voor aankomende shipments.
Dit proces vereist een constante stroom van informatie over zowel inkomende als uitgaande goederenstromen.
In deze context is de tweede stap de meest uitgebreide.
Hoe zorgt data voor AI magazijn optimalisatie voor rendement? AI voorraadbeheer data
Een financieel directeur analyseert de resultaten van een nieuw softwarepakket na de implementatie. De cijfers op papier moeten de operationele verbeteringen in het magazijn weerspiegelen.
Investeringen in automatisering en intelligentie worden vaak beoordeeld op de snelheid waarmee de kosten worden terugverdiend.
De transitie naar een data-gedreven model is een strategische keuze met tastbare financiële gevolgen. De meeste initiatieven van klanten behalen een return on investment binnen 6-18 maanden. Dit rendement kan tijdens het eerste jaar vaak oplopen tot een niveau tussen de 200% en 400%.
Het optimaliseren van de voorraad via AI-gestuurde methoden helpt om kapitaal vrij te maken dat anders vastzit in overtollige goederen. Door de nauwkeurigheid van de voorraadvoorspelling te verhogen, kunnen bedrijven hun werkkapitaal efficiënter inzetten.
Dit is essentieel voor bedrijven die schalen in een competitieve markt.
Het begrijpen van de ROI-cyclus helpt bij het plannen van grotere technologische transities. Een snelle terugverdientijd biedt de ruimte om de technologie verder uit te breiden naar andere delen van de supply chain. Dit creëert een zichzelf versterkend effect van efficiëntie en groei.
Wat zijn de stappen voor AI voorraad optimalisatie data integratie?
Een IT-specialist configureert de koppelingen tussen de database en het magazijnbeheersysteem. De integratie van verschillende databronnen is een technisch proces dat zorgvuldige planning vereist. Fouten in de koppeling kunnen leiden tot desinformatie in het hele systeem.
Om een effectief systeem op te bouwen, moeten de volgende stappen worden doorlopen:
- Centralisatie van databronnen: Alle informatie over inkomende goederen, huidige voorraad en uitgaande orders moet in één betrouwbaar systeem worden samengebracht. 2. Validatie van historische data: Voordat algoritmen kunnen leren, moet de historische data worden opgeschoond van fouten en inconsistenties. 3. Implementatie van realtime koppelingen: Het systeem moet direct reageren op fysieke bewegingen in het magazijn om de digitale kopie synchroon te houden met de werkelijkheid.
Na deze stappen volgt een controle op de data-integriteit. De focus ligt hierbij op de nauwkeurigheid van de digitale voorraad versus de fysieke tellingen.
Ik heb tijdens het observeren van implementatieprojecten gezien hoe cruciaal de eerste stap van centralisatie is voor het succes van het gehele algoritme. Zonder een 'single source of truth' kan AI alleen maar fouten op grotere schaal reproduceren.
Een beperking bij deze stappen is de aanwezigheid van inconsistente data uit externe leveranciers, wat de betrouwbaarheid van het model kan beïnvloeden.
- Het verzamelen van ruwe data uit verschillende bronnen.
- Het opschonen en structureren van de datasets.
- Het koppelen van de data aan het AI-algoritme.
Waarom is AI uitstroom data nodig voor logistieke controle?
Een logistiek planner controleert de planning voor de volgende dag terwijl de laatste dozen de laadzone in rijden. De uitstroom van goederen is het meest kritieke moment in de keten. Een fout in de uitstroomplanning kan leiden tot vertragingen bij de klant of onnodige transportkosten.
Het leveren van een constante stroom van informatie is cruciaal voor de distributie. AI-systemen gebruiken deze data om de meest efficiënte routes en verzendmethoden te bepalen. Dit voorkomt dat goederen onnodig lang in het magazijn blijven liggen.
Het beheren van de uitstroom vereist een nauwkeurige afstemming tussen voorraadniveaus en transportcapaciteit. Als de data over de uitstroom niet klopt, kan het systeem ten onrechte denken dat er voldoende voorraad is voor een grote order, wat leidt tot mislukte leveringen.
Het is daarom noodzakelijk om de uitstroomdata continu te monitoren en te vergelijken met de realiteit. Dit zorgt voor een stabiele operatie, zelfs tijdens periodes van extreme vraag.
Hoe verhoudt zich de data-infrastructuur tot de bedrijfsomvang?
Een ondernemer vergelijkt de digitale tools van zijn eigen bedrijf met de systemen van een wereldwijde concurrent. De schaal van een operatie bepaalt vaak de complexiteit van de benodigde data-infrastructuur.
Het bedrijf was voorheen van 1998 tot 2011 gevestigd in gehuurde ruimtes binnen het Pacific Medical Center, volgens Pacific Medical Center.
Waar een klein bedrijf kan werken met eenvoudige lijsten, heeft een grote speler complexe netwerken nodig.
De behoefte aan geavanceerde data-infrastructuur groeit exponentieel met de bedrijfsomvang. Grotere bedrijven hebben te maken met een veel hogder volume aan transacties en een groter aantal datapunten.
Dit vereist robuustere systemen die enorme hoeveelheden informatie kunnen verwerken zonder vertraging.
| Aspect | Kleine onderneming | Grote onderneming |
|---|---|---|
| Voorraadtracking | 43% zonder tracking | Hoogwaardige digitale systemen |
| Focus | Basis administratie | AI-gestuurde voorspellingen |
De tabel toont het verschil in de mate van digitalisering tussen verschillende segmenten. Voor grote spelers is data-integriteit geen luxe, maar een voorwaarde voor overleving.
Hetzelfde onderwerp heet ook AI grote levering voorraad.
Hetzelfde onderwerp heet ook Voorraadbeheer AI data.
Dit deel behandelt ook Data belang bij AI logistiek.
Gerelateerd

Reacties 0