AI企業 データ統合 戦略で収益性の比較を可能にする
膨大なデータが生成され続ける現代において、AI企業の競争力はデータの統合と活用能力に直結しています。
AI企業がデータ統合を通じて運営効率と意思決定の質を高めるには、分散した情報を一元的な基盤へと集約し、戦略的な指標に基づいた管理を行う必要があります。本記事では、データ統合の具体的なステップや、データ活用における実践的な視点、そしてデータドリブンな意思決定に向けた基盤構築方法について解説します。
本稿では、AI企業におけるデータ統合の戦略的価値を検討します。データ統合で業務効率化を図るための具体的なプロセス、AI活用におけるデータ整備の重要性、そしてデータドリブンな意思決定法を確立するための手順を提示します。また、統合データ基盤構築方法の検討における限界についても触れます。
AI企業にとって、データ統合はなぜ重要で、今はどのような状況なのか?
深夜の静まり返ったオフィスで、サーバーの熱気を感じながら、彼は将来の競争力を左右する企業のデータ基盤を見つめていた。
オフィスの一角で、サーバーの稼働音を聞きながらデータ基盤の設計図を見つめる場面を想像してください。
AI企業にとって、データ統合は単なる技術的な作業ではなく、ビジネスの根幹を支える戦略です。データ統合で業務効率化を実現することは、複雑化するAIモデルの学習や運用におけるボトルネックを解消するために不可欠です。情報の断片化を防ぎ、組織全体で一貫したデータを利用できる環境を整えることが、迅速な意思決定を可能にします。
AI活用におけるデータ整備は、モデルの精度を左右する重要なプロセスです。整備されていないデータは、誤った予測や非効率な運用を招くリスクがあります。データの品質を維持しつつ、どのように統合を進めるかが、企業の競争力を左右します。
データドリブンな意思決定法を確立するためには、まず現状のデータフローを可視化することから始まります。情報の流れを整理し、どのデータがどの意思決定に寄与しているのかを明確にする必要があります。
統合データ基盤構築方法の検討においては、スケーラビリティとセキュリティの両立が求められます。将来的なデータ量の増加を見越し、柔軟な拡張性を持つ設計が不可欠です。
AIモデルの精度は、学習に使用されるデータの質と量に直接依存します。断片化されたデータ環境では、情報の欠落や重複が発生し、モデルのバイアスや予測精度の低下を招くリスクがあります。
データ統合の具体的なステップと実践的なアプローチ AI企業 データ統合 戦略
会議室の窓から朝日が差し込む中、チームは複雑な手順を整理しながら、企業のデータ統合に向けた具体的な作業に手を動かしていた。
新しいプロジェクトの開始時に、チームが集まってデータの統合プロセスを議論する様子を想像してください。
データ統合の具体的なステップを理解することで、複雑なプロジェクトを管理可能なタスクへと分解できます。以下の3つのステップが、標準的なアプローチとなります。
- データソースの特定とカタログ化:社内に散らばるデータベース、クラウドストレージ、APIなどのソースをすべて洗い出し、その特性を整理します。 2. データクレンジングと標準化:異なる形式のデータを統一されたスキーマに変換し、重複や欠損を排除して、分析可能な状態に整えます。 3. ETL/ELTプロセスの自動化:抽出(Extract)、変換(Transform)、格納(Load)のプロセスを自動化し、常に最新のデータが基盤に反映される仕組みを構築します。
最後に、データの整合性とアクセス権限が正しく設定されているかを確認します。
私が以前、大規模なデータ移行プロジェクトに携わった際、このステップを一つずつ丁寧に踏むことで、予期せぬエラーを最小限に抑えられた経験があります。
ただし、全てのデータが統合の対象になるわけではありません。機密性の極めて高いデータや、一時的な作業用データなどは、統合の範囲外として個別に管理されるべきケースもあります。
- 異なるソースからのデータ抽出とクレンジングを行い、形式を統一する。
- データの整合性を検証し、重複や矛盾を排除するプロセスを確立する。
- 統合されたデータをAIモデルが直接利用可能な形式で蓄積する。
統合データ基盤の構築と意思決定の質
データセンターのサーバーラックが整然と並ぶ様子を目の当たりにすると、その秩序の重要性がわかります。
統合データ基盤構築方法の確立は、組織の意思決定をデータに基づいたものへと変貌させます。データが統合されることで、部門間の情報の壁が取り払われ、全社的な視点での分析が可能になります。
AI活用におけるデータ整備が適切に行われていれば、経営陣は客レット的な数値に基づいて迅速に戦略を修正できます。これは、市場の変化が激しいAI業界において、生存するための必須条件です。
データドリブンな意思決定法を実践する上で、基盤の信頼性は絶対です。統合されたデータが正確でなければ、どれほど高度な分析モデルを用いても、誤った結論を導き出すことになります。
データ統合の具体的なステップを確実に実行し、整備されたデータを基盤に据えることが、AI企業の成功への道筋となります。
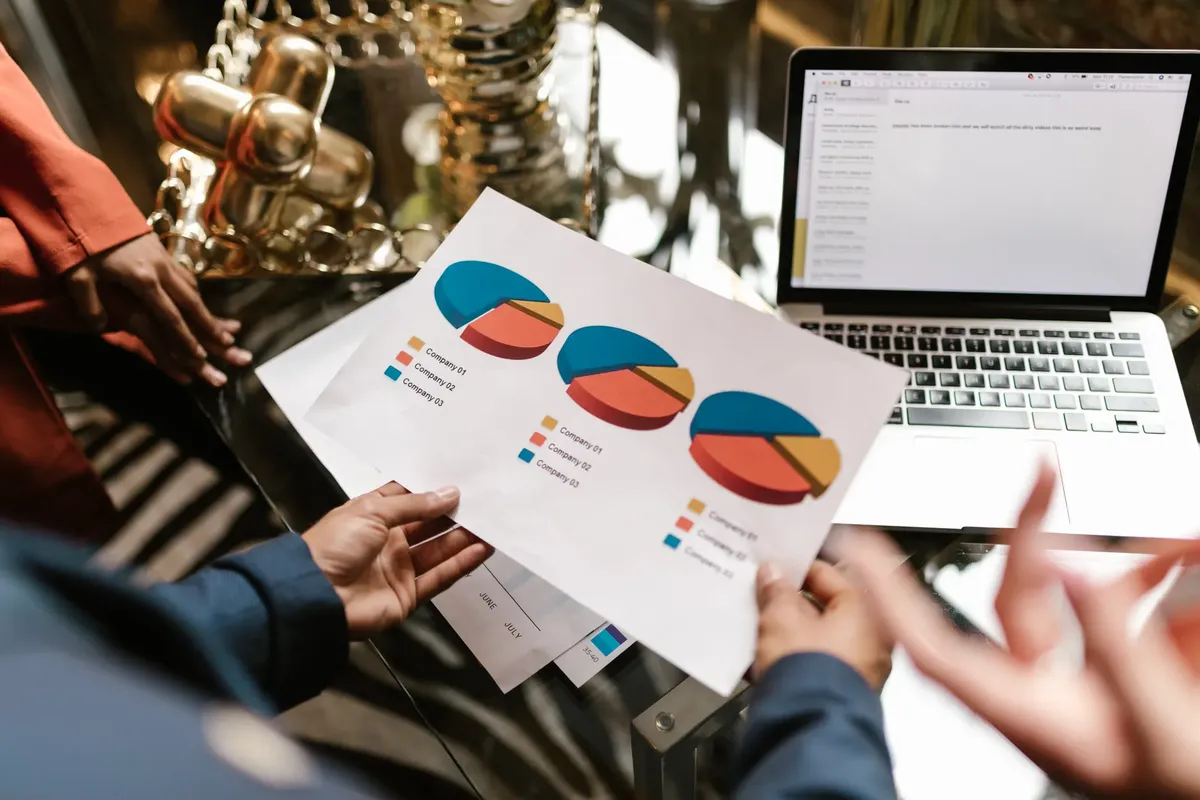
一貫性のあるデータ基盤が整備されることで、経営層はリアルタイムかつ正確な情報に基づいた判断が可能になります。データの散在による判断の遅延や、誤った解釈によるリスクを最小限に抑えることができます。
収益性と戦略的指標の比較
異なるビジネスユニットのパフォーマンスを比較する際に、共通の指標を用いる場面を想定してください。 Desert Research Instituteの計算によると、2026年時点でのネバダ州における全計画プロジェクトが完了した場合、2030年までに州のエネルギー生産量の35%がデータセンターに割り当てられる可能性があります。
戦略的なデータ統合は、単なる作業効率の向上だけでなく、収益性の分析においても決定的な役割を果たします。複数の事業部門を持つ企業では、共通のデータ基盤を用いることで、公平な比較が可能になります。
| 分析の視点 | 統合データによる影響 |
|---|---|
| 収益性の比較 | 共通の指標を用いた部門間のパフォーマンス評価が可能になる |
| 成長機会の特定 | 蓄積されたデータから、市場のトレンドや潜在的な需要を捉えられる |
データ統合で業務効率化を図ることは、間接的にコスト削減と収益向上に寄与します。情報の検索や加工に費やされていた時間が、より価値の高い分析業務へと転換されるからです。
単なるコスト削減だけでなく、データ統合による業務効率の向上や、精度の高い予測による機会損失の防止が、長期的な収益性に寄与します。戦略的な指標として、データ活用による意思決定の速度と正確性を評価することが重要です。
データ統合における課題と限界
システムの複雑さに直面し、技術チームが解決策を模索する緊張感のある場面を想像してください。 The International Energy Agencyの推計によると、これらのデータセンターによる電力消費量は2024年において約415テラワット時(TWh)に達し、これは世界全体の電力消費量の約1.5%に相当しました。
データ統合には、技術的、組織的な課題が常に存在します。統合データ基盤構築方法を設計する際、これらの限界をあらかじめ認識しておくことが重要です。
AI活用におけるデータ整備において、データの量と質を同時に追求することは困難な場合があります。あまりに厳格なクレンジングは、計算コストを増大させ、リアルタイム性を損なう可能性があります。
データドリブンな意思決定法を導入する際も、組織文化の壁が立ちはだかることがあります。データに基づいた判断を受け入れる文化がなければ、どれほど優れた基盤を構築しても、その価値を十分に引き出すことはできません。
データ統合の具体的なステップを進める中で、既存のレガシーシステムとの互換性が問題になることもあります。古いシステムから新しい基盤への移行は、技術的なリスクを伴う作業です。
このように、データ統合のプロセスには常に技術的な限界や運用上の制約が伴います。
データの鮮度維持や、異なるシステム間のスキーマの不一致といった技術的課題は常に存在します。また、データの統合が進むほど、プライバシー保護やセキュリティ管理の複雑さが増大するという側面もあります。
関連記事



コメント 0